AWS 提出 Amazon Bedrock 集中式可觀測性資料湖架構,追蹤調用與 Token 成本
企業 AI 導入
AWS 發布架構指南與範例儲存庫,用於建立 Amazon Bedrock 的集中式可觀測性資料湖。該方案利用 Amazon CloudWatch、Lambda、Amazon Data Firehose 與 Amazon Athena 跨帳號彙整模型調用日誌。結合成本與使用情況報告(CUR)後,企業可跨團隊分析 Token 消耗、提示詞效率與單次調用開銷。
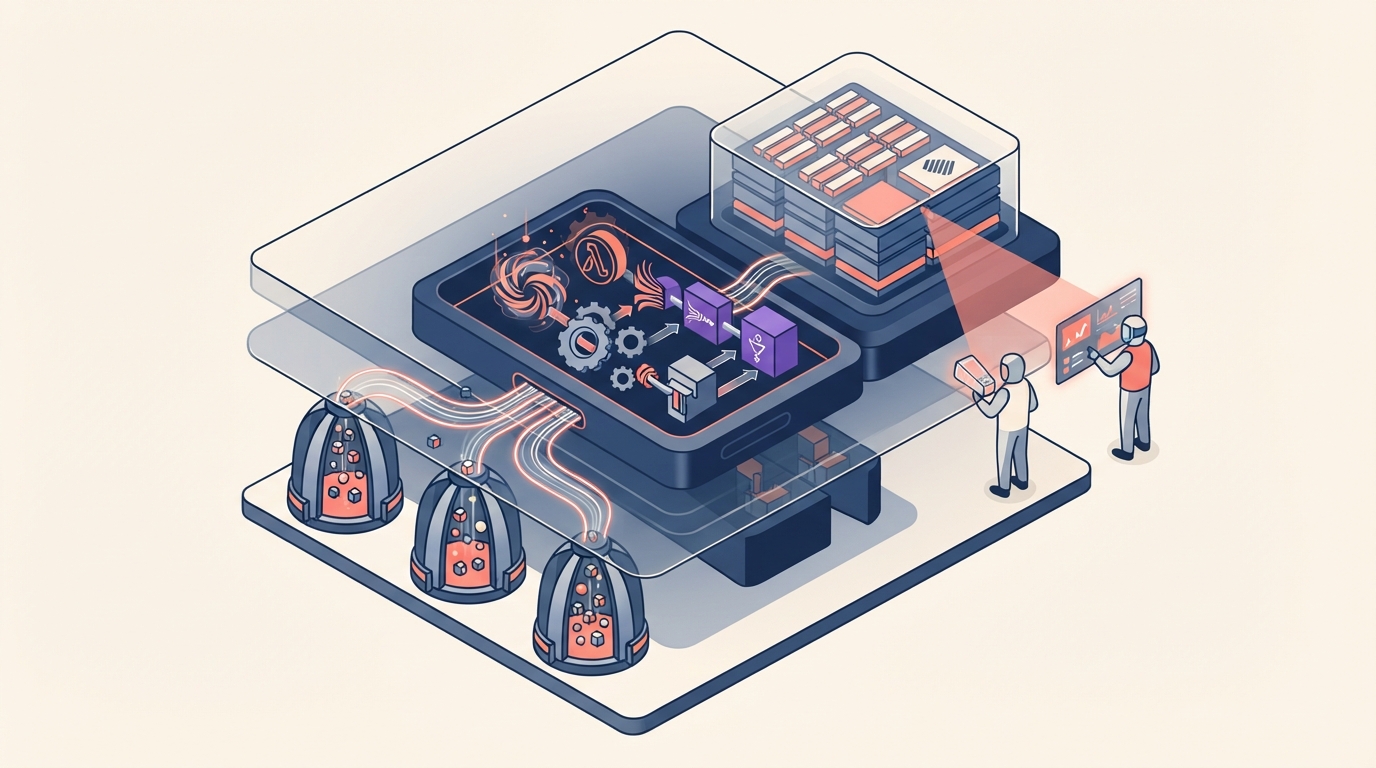
AWS 分享了一項架構模式,協助平台與機器學習工程師在分散的 Amazon Bedrock 環境中管理 Token 經濟。雖然 Bedrock 原生調用日誌可擷取請求內容與 Token 數據,但紀錄通常分散於各個個別 AWS 帳號中。該解決方案透過 AWS CloudFormation 範本部署跨帳號資料收集管線。 在此架構下,各關聯帳號啟用 Bedrock 日誌並傳送至 Amazon CloudWatch 日誌群組,再透過訂閱篩選條件將紀錄轉發至中央帳號。中央管線中的 AWS Lambda 函式會剔除系統雜訊、解開批次事件並扁平化調用者身分欄位。隨後 Amazon Data Firehose 將 JSON 轉換為分區 Parquet 檔案並寫入 Amazon S3,讓團隊可透過 AWS Glue 與 Amazon Athena 執行 SQL 查詢。 整合後的資料集記錄了提示詞、模型回應、Token 數量、所選模型、中斷原因、時間戳記與 IAM 角色。AWS 表示,藉由 IAM ARN 將這項資料與成本與使用情況報告(CUR 2.0)聯結,可實現細緻的成本歸屬,找出高成本提示詞並掌握各團隊的使用趨勢。團隊亦可搭配 Cloud Intelligence Dashboards 架構部署 AWS QuickSight 儀表板以進行視覺化分析。
值得帶走的重點
- AWS 發布範例儲存庫與 CloudFormation 範本,可將多個帳號的 Amazon Bedrock 調用日誌集中至單一資料湖。
- 資料流程透過 CloudWatch 訂閱篩選條件、Lambda 前處理與 Amazon Data Firehose,將紀錄以 Parquet 格式寫入 Amazon S3 供 Athena 查詢。
- 扁平化日誌完整記錄提示詞、回應內容、輸入與輸出 Token 數、模型種類、時間戳記、結束原因與調用者 IAM 角色。
- 將查詢結果與成本與使用情況報告聯結,使工程團隊能將 Token 消耗對應至特定部門支出,並找出低效的模型提示詞。
來源:AWS Machine Learning 閱讀原文 ↗
本篇由 AI 整理、核對並自動發布,未經逐篇人工審核。譯文經 AI 複核。